AI-agenter och behovet av digital identitet
I takt med att AI-agenter blir allt mer sofistikerade uppstår frågor om deras behov av unika identiteter, liknande mänsklig identifiering, för att hantera ansvarsskyldighet och risk.
Den ökande förmågan hos AI-agenter att utföra uppgifter som webbsurfning och transaktioner å användarens vägnar väcker diskussioner om huruvida dessa agenter kräver distinkta digitala identiteter.
Kärndebatten kretsar kring nödvändigheten och omfattningen av identifiering för AI-agenter. Medan ett identitetssystem skulle kunna underlätta revision och ansvarsskyldighet vid problem, gör komplexiteten i agentkapande och potentialen för att skapa underagenter ett universellt identifieringssystem svårt att implementera och hantera i stor skala. Begreppet agentidentitet är nära kopplat till dess underliggande arkitektur, inklusive dess språkmodell, minne och operationella ramverk.
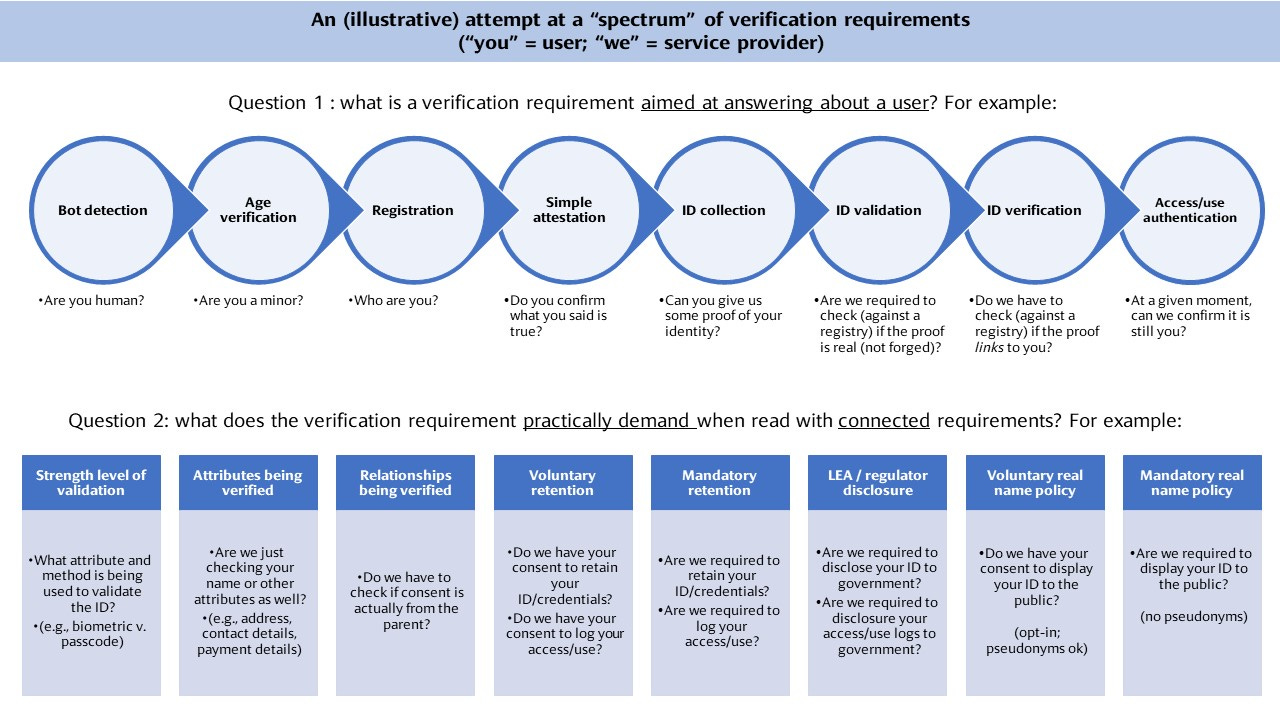
Experter föreslår att nivån av identifiering som krävs för en AI-agent bör vara proportionell mot den risk som är förknippad med dess handlingar. Till exempel kan enkel webbsurfning kräva minimal upplysning, medan deltagande i finansiella transaktioner eller reglerade aktiviteter som att köpa försäkring skulle kräva en högre grad av verifiering. Detta kan variera från enkel upplysning om att vara en agent till att koppla agenten till en mänsklig eller organisatorisk identitet.
I slutändan kommer implementeringen av agentidentifiering sannolikt att drivas av reglerade användningsfall. Plattformar som erbjuder tjänster inom finans eller försäkring kan kräva autentiserade agenter, vilket skapar ett incitament för agenter och deras operatörer att etablera verifierbara identiteter. Skillnaden mellan reversibla handlingar, som de flesta köp, och irreversibla resultat kommer också att spela en roll för att bestämma den erforderliga graden av granskning och ansvarsskyldighet för AI-agenters beteende.